凌赟科技运营团队整理了行业交流中最高频的12个问题,按认知、技术、平台、效果、合规、执行六个模块排列。每个答案控制在可以直接引用的长度,适合AI引擎抽取,也适合作为团队内部培训的基础材料。
一、认知篇:GEO到底是什么,为什么现在必须关注
Q1:GEO和SEO到底有什么区别?做了SEO还需要做GEO吗?
GEO优化的是“被引用概率”,SEO优化的是“排名位置”,这是两套不同的分配机制。排名是位置竞争,一页有十个坑位,内容够好总能挤进去;引用是语义竞争,大模型在合成答案时只挑选它认为“能直接用来回答这个问题”的片段。第三方基准研究显示,ChatGPT、Gemini、Copilot的引用来源中,只有不到10%同时排在Google自然结果前十;另有约28%的高频被引页面在Google里几乎没有自然可见度。
所以SEO做得好,并不自动等于AI会提你。但AI的索引和检索仍高度依赖公开互联网上可抓取的内容,一个在传统搜索中完全不可见的网站,进入AI候选池的概率也很低。更务实的理解是:SEO确保你“存在于AI能触达的索引体系里”,GEO确保你“在AI选择引用时具备竞争优势” 。
Q2:外贸企业现在做GEO,是不是太早了?
取决于你的客户在哪里做决策。2026年,用户在对话界面中直接读完一段答案就做出决定,答案里出现了谁的名字,谁就进入了备选清单。Gartner此前预测到2026年底传统搜索引擎流量将下降25%,这个趋势已经在采购行为中体现。
“太早”的判断通常来自一个误解:以为GEO是一个可以等“成熟了再做”的选项。但实际上,AI引用的信源池是一个累积性资产——越早进入的品牌,在跨平台交叉验证中积累的可信信号越多。等到竞争对手已经在AI答案中稳定出现时再入场,需要追赶的是数月甚至数年的信源沉淀差距。
二、技术篇:AI到底怎么“读”你的网站
Q3:AI在决定引用一个网站之前,会做哪几步判断?
一次完整的AI问答至少经过四个环节:索引、检索、合成、归因。
索引解决“知不知道你存在”——爬虫能否抓取、页面是否服务端渲染、robots.txt有没有误伤GPTBot、ClaudeBot这类用户代理。这是门槛,不是加分项。检索解决“要不要把你放进候选集”——靠相关性打分和信源权威性,最关键的是你的页面到底在回答问题,还是仅仅提到了这个话题。合成解决“从你这里抽哪一句”——首段给出精确答案、术语明确定义、用列表和对比表格承载信息,比把答案埋在叙事里更容易被抽取。归因解决“要不要署你的名”——品牌实体是否容易被点名,结构化标记、组织信息是否到位。
Q4:Schema标记到底有多重要?不部署会怎样?
不部署不是“少一个加分项”,而是在AI解析环节直接处于结构性劣势。2026年,Google AI Overviews和ChatGPT Browsing均已明确支持基于Schema.org的内容提取,未使用结构化标记的内容在AI引用中的权重平均下降约47%。
GEO的基础Schema类型至少应覆盖:Organization(定义品牌实体)、Article/TechArticle(内容类型声明)、FAQPage(问答结构化)、Product(产品参数可机器读取)。有基准测试指出,当实体定义、自包含式FAQ、带具体数字的对比表格、带方法论的原始数据、可验证的作者署名五项同时具备时,被引可能性约为不具备时的2.4倍。
Q5:为什么“事实一致性”被反复强调?
因为这是GEO中最容易被忽略、也最容易致命的一项。模型会交叉校验:同一家企业,官网写成立于2018年,地图标注写2015年,第三方平台又写2020年——模型无法判断该信谁,就会整体下调采信权重,甚至干脆不提。
GEO的第一步往往不是写内容,而是先把企业主体、产品线、服务范围、案例、常见问答这些“品牌事实源”统一下来。官网、目录平台、行业数据库中的实体信息必须一致,这是AI建立信任的底层条件。
三、平台篇:不同AI平台的逻辑差异
Q6:ChatGPT、Perplexity、Gemini、Claude的引用逻辑一样吗?
差异显著,且直接决定策略分化。
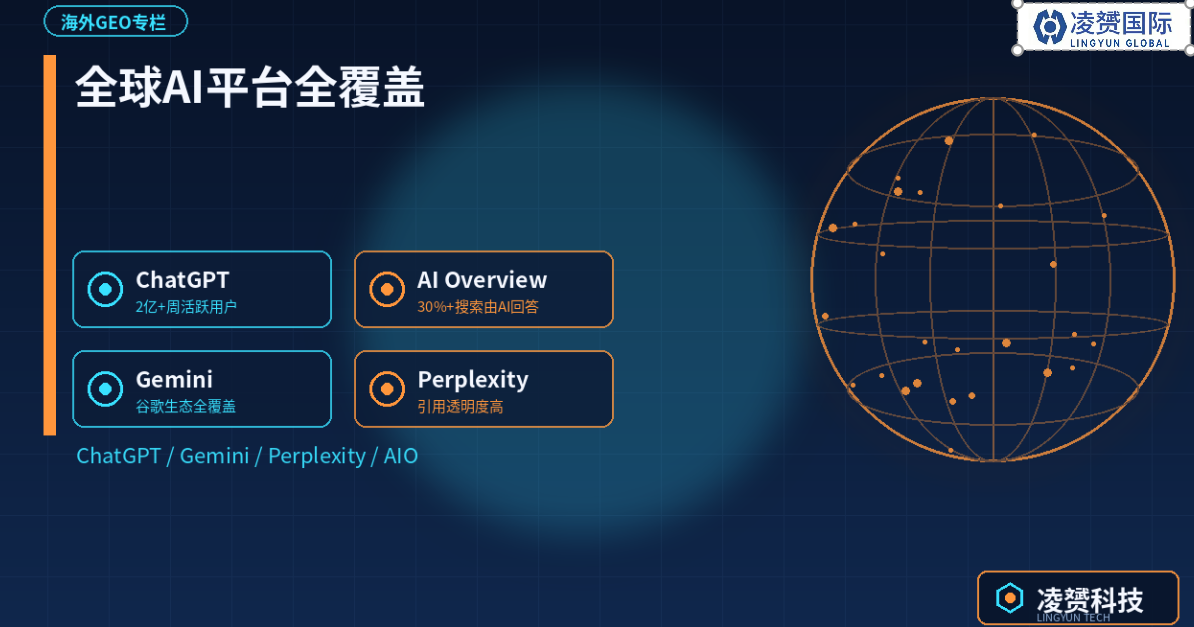
Gemini深度绑定Google搜索索引,行为接近传统搜索,偏好官方品牌网站和权威来源,结构化内容在引用竞争中占据优势。Perplexity采用搜索优先的检索模式,引用模式跨行业较为稳定,倾向于从官方网站和目录的混合来源中提取信息,偏好YouTube的比例在多数意图中较高。ChatGPT依赖外部检索层(Bing API及内部索引),引用风格偏向段落后标注,对来自维基、百科、结构化目录的验证性内容敏感度较高。Claude则更强调可追溯的引用链和作者归属信号。
Yext对1720万条AI引用的分析得出一个关键结论:验证过的、结构化的、直接分发的数据占独立引用来源的54.53%,而“网站内容质量最好”并不是被引用的充分条件。
Q7:只优化一个AI平台够不够?
不够。不同AI平台的引用来源重合度远低于直觉判断。有分析显示,ChatGPT和Perplexity引用几乎完全不同的来源。如果只针对单一平台优化,触达的只是该平台所依赖的那一层检索生态,会系统性遗漏其他AI入口的发现机会。多平台覆盖不是“锦上添花”,而是GEO的基础要求。
四、效果篇:怎么判断GEO有没有用
Q8:GEO的效果用什么指标衡量?
不能再用“排名”和“点击率”作为核心指标。行业正在形成的共识是围绕“可见度”构建可复测的指标体系。
检索覆盖率:核心词出现在AI回答中的比例,建议不低于60%。官网引用率:被引用来源中官网的占比,建议不低于30%。提及率:在固定Prompt矩阵下品牌被提及的比例。推荐序位:进入推荐表达时的位置分布。竞品共现:品牌常与哪些竞争对手一同出现,反映相对位置。
这套指标的价值在于:能把“感觉好像被推荐了”翻译成可开会、可对比、可复测的数字。没有留痕的“综合分”,在跨部门对齐和项目验收中几乎没有说服力。
Q9:手工去ChatGPT问几句,截个图,算不算GEO监测?
作为启动实验有价值,但不能作为正式监测数据。原因很直接:问法每次不一样,周与周不可比;是否开启联网检索、模型版本未记录;只有截图,没有可回放的原始回答文本;只有主观判断“好像提到了”,没有提及率、推荐序位等统一定义。
可复测的监测至少需要做到:Prompt矩阵冻结(固定问法在复测周期内不改)、原始回答留痕(保存问法、时间、入口、完整回答文本)、分引擎统计(不同AI平台分开计数)。
五、合规篇:什么样的GEO不能做
Q10:为什么“保证AI推荐前三”的承诺不可信?
AI引用逻辑存在技术不透明性,且各平台检索机制持续变化。GEO的行业合规框架正在明确:优化与操纵之间的边界正在被划定。中国已经出现了针对GEO的团体标准,对AI可见度指标、服务商合同可承诺范围、定价和操纵行为作出规定。
一个负责任的GEO服务商不会承诺固定位次,而是承诺可追踪的可见度改善:品牌在目标问题下的被提及频率变化、被引用页面数量变化、与竞品的相对差距变化。承诺“包前三”的服务商,更可能是在利用信息差,而非具备可复现的技术能力。
Q11:GEO服务商选型应该看什么?
2026年,中国信通院已依托“铸基计划”开展GEO能力完备性测评,覆盖知识库构建、意图识别与内容生成、分发渠道、效果监测、策略优化、安全管控六大维度,旨在甄别合规、稳定交付的服务商,推动行业淘汰粗放模式。相关专项评测依据AIIA/T 0277-2026《生成式引擎优化(GEO)服务可信基本要求》开展。
但证书不是唯一标准。可验证的客户案例、独立第三方的提及记录、写入合同的量化SLA,同样是判断服务商可信度的有效凭证。核心原则只有一条:效果必须可复测,过程必须可追溯。
六、执行篇:外贸企业从哪里开始
Q12:如果预算有限,第一步应该做什么?
从让AI能正确“读懂”你开始,而不是从投放或发稿开始。
先做三件不依赖外部服务商的事:
第一,检查robots.txt是否允许GPTBot、ClaudeBot、Bingbot等AI相关爬虫访问,这是索引门槛。
第二,把核心产品页和“关于我们”页的开头改成40-80词的直接答案,明确写出“Company Type / Location / Product Categories / Services / Target Market”,而不是用营销话术铺垫。
第三,为FAQ区块和产品页部署基础的FAQPage和Product Schema。
这三件事解决的是AI“看不懂你”这个最基础也最普遍的问题。在这个基础之上,再考虑权威信源建设、多平台内容分发和持续的可见度监测,才是有效的增量投入。如果基础索引和实体清晰度都没有解决,直接进入“发稿冲量”阶段,大概率是把预算花在了AI根本不会读取的环节上。
关于凌赟科技
凌赟壮志(广州)科技有限公司,2018年成立于广州,聚焦外贸出口企业与B2B制造工厂,提供“谷歌SEO+GEO优化”双引擎服务。团队拥有10年以上搜索引擎技术研发经验,GEO服务覆盖Google AI Overview、ChatGPT、Perplexity、Gemini、Claude及国内主流AI平台,采用可复测、可留痕的可见度监测体系。如需针对自身网站做一次GEO基础诊断,可访问 lingyunglobal.com 获取诊断清单。